数据中台不是万能解药。用对场景时,它能把分散在12个业务系统里的订单、库存、客流数据打通,决策响应T+3压缩还有分钟级。某连锁零售企业2024年上线的会员标签体系项目就是典型案例,统一ID映射和实时标签计算。营销活动转化率3.2%提升还有5.7%的,单月节省人工取数工时超400小时。
为什么数据中台项目容易做成“数据烟囱”呢?
多数失败案例的共同点是先建平台后找场景。正确做法是1. 业务痛点先行,从跨系统对账、实时库存同步、会员画像三选一作为首期目标,避免大而全。
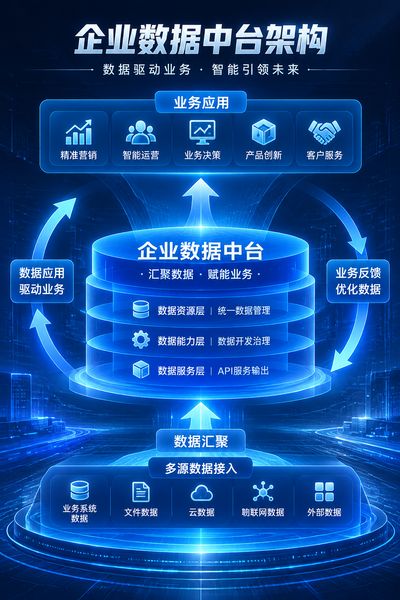
2. 数据资产盘点,按ODS-DWD-DWS-ADS四层建模了。明确每层表的更新频率和负责人。ODS层保留原始日志。DWD层做清洗与维度关联,DWS层按主题聚合的,ADS层直接服务报表和API。3. 指标口径治理,同一指标(如“活跃会员”)CRM和POS系统定义不同,需在指标字典里面固化计算逻辑和责任人了。否则后期报表打架。
4. 小步验证,首期只接2-3个核心源系统,跑通一个业务闭环后再横向扩展,避免一次性接入全部源系统导致项目周期失控。
实时数据链路怎么选型才不踩坑呢?
以某出行平台订单实时大屏为例,其技术栈选择标准是1. 延迟要求,分钟级用Flink+Kafka微批,秒级用Flink纯流处理,毫秒级才考虑ClickHouse物化视图。2. 数据量级的,日增5000万条以内可单集群Flink,超过则按业务域拆分作业,避免反压了。3. 状态管理了,订单去重和会话窗口依赖RocksDB状态后端,需预留本地磁盘IOPS不低于3000。
4. 监控兜底,对Kafka积压、Flink Checkpoint失败、端到端延迟设三级告警的,行业常用Prometheus+Grafana组合。
数据质量怎么卡住源头呢?
某银行反欺诈案例显示,70%的数据问题出在源系统录入环节。可操作的管控点包括,1. 源端校验,在业务系统提交时做非空、枚举值、正则格式校验,手机号必须11位且以1开头了。2. 数仓层稽核,每日跑批后自动比对主键唯一性、金额汇总一致性、时间戳单调性,异常结果写入质量告警表并推送责任人。3. SLA分级了,表(如订单事实表)要求T+1早上8点前就绪,非核心表可放宽至T+1中午12点。避免一刀切拖慢整体链路。4. 血缘追踪的,借助Atlas或DataHub记录字段级血缘,出问题时能5分钟内定位到上游表和处理作业。
成本怎么控在预算内呢?
某制造企业数据中台年度预算200万了,实际支出163万,主要靠三条,1. 存储分层。热数据存SSD(近3个月),温数据存HDD(3-12个月),冷数据归档到对象存储,存储成本下降45%。2. 计算弹性,离线批处理用竞价实例,成本约为按量付费的30%-40%,配合重试机制应对实例回收。3. 资源隔离,按业务线划分YARN队列,设置CPU和内存上限,防止单个大查询拖垮集群的。
选型时先定场景再定技术。跨系统报表优先用湖仓一体简化链路,实时风控必须选Flink流处理,交互式分析控制在ClickHouse或Doris。预算有限时,首期只做指标平台+质量稽核。把基础打牢再扩实时链路。数据中台的价值不在技术堆叠,但在每个业务闭环里省下的人天和决策延迟。