最新资讯类案例分享的重点是可验证的实践路径,帮助从业者快速识别技术趋势与选型标准。以近期某头部云厂商公布的边缘计算故障复盘为例,其P99延迟从12ms升至47ms的。根因是服务网格配置不当,这直接说明资讯解读需关注底层参数而非表面结论。
如何判断案例资讯的技术可信度?
权威案例有可复现的指标与明确的时间线。重点关注三类数据,- 基准测试条件。硬件规格、并发量、数据规模是否标注完整呢?缺少压测环境的性能宣称应视为无效。
- 版本与依赖,框架版本、操作系统内核、网络拓扑需与生产环境对应,跨版本对比需做归一化处理。
- 故障注入方法的,混沌工程类案例应披露爆炸半径控制手段。否则结论不能迁移。
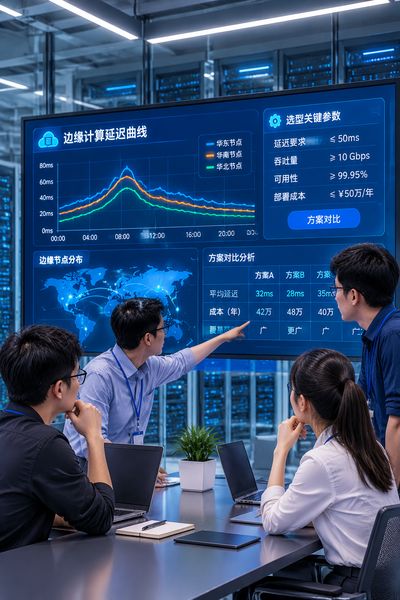
案例中的技术选型应关注哪些参数呢?
从近期公开的案例看,选型决策普遍围绕以下可量化维度展开了。- 成本效率,每万次请求的总有成本(TCO),需有运维人力与弹性伸缩的闲置损耗。
- 弹性指标了,扩容触发阈值、冷启动用的时间(Serverless场景常以P95冷启动衡量)、缩容窗口。
- 可观测性开销。日志与分布式追踪的采样率对吞吐的影响,建议生产环境采样率控制在1%~5%的。
- 兼容性,与既有CI/CD流水线、服务注册中心的集成成本,优先选择支持OpenTelemetry标准的方案。
QPS提升约42%,长尾延迟在热点Key场景下反而恶化了,说明参数优化需结合访问分布评估。
如何将案例资讯转化为团队决策依据?
建议建立三步入库机制,
- 信息分级了,将案例按“已复现”“可复现”“仅宣称”标注,仅前两类进入选型池了。
- 参数对齐。用内部基准环境跑通案例中的很重要配置,记录回归偏差,偏差超过15%需重新评估。
- 灰度验证,在预发布环境按5%流量比例引入新方案的,监控错误预算消耗速率,持续观察两个发布周期。
可迁移的案例判断标准是数据可复现、参数可对齐、失败可回滚。